指南 · AI 搜索
AI 爬虫和 robots.txt:各个爬虫做什么,怎么分别设置
简单说
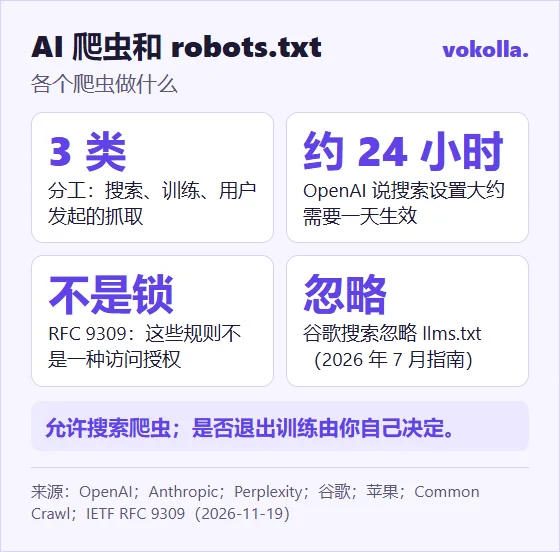
AI 公司运行几种分工不同的爬虫:为带链接的回答抓取页面的搜索爬虫、收集训练数据的爬虫,以及用户提问时才行动的抓取工具。它们的所有者各自说明了独立的 robots.txt 标识,例如 ChatGPT 搜索用 OAI-SearchBot,训练用 GPTBot。robots.txt 是请求,不是访问控制。要不要退出训练由你决定;各家厂商说明了这项设置,但没有建议选哪一种。
各个爬虫做什么,按所有者的说法
| 爬虫 | 用途(按所有者的说法) | 说明 |
|---|---|---|
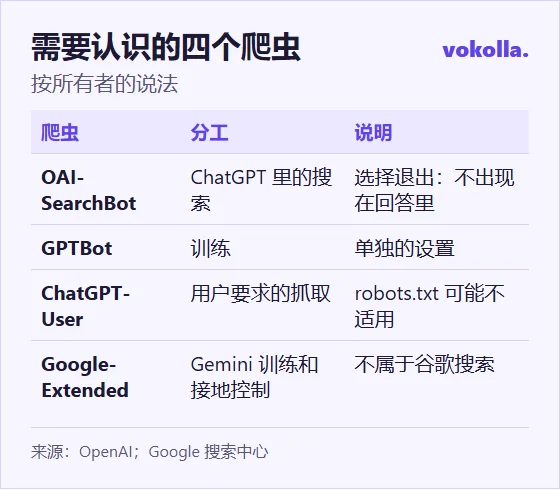
| OAI-SearchBot(OpenAI) | ChatGPT 里的搜索 | 选择退出的网站不会出现在 ChatGPT 搜索回答里,但仍可作为导航链接出现;调整大约需要 24 小时 |
| GPTBot(OpenAI) | 训练生成式 AI 基础模型 | 禁止它,表示内容不应用于训练 |
| ChatGPT-User(OpenAI) | 由用户发起的动作 | robots.txt 规则可能不适用 |
| ClaudeBot(Anthropic) | 收集可能用于训练的网络内容 | Anthropic 说它的爬虫遵守 robots.txt 指令 |
| Claude-User、Claude-SearchBot(Anthropic) | 按用户指示检索;为搜索建立索引 | 禁用它们,可能降低在搜索里的可见度 |
| PerplexityBot | 在 Perplexity 搜索中呈现并链接网站 | 不用于抓取内容训练 AI 基础模型;Perplexity-User 一般忽略 robots.txt |
| Google-Extended | 控制谷歌抓取的内容能否用于训练未来的 Gemini 模型,以及在 Gemini 应用和 Vertex AI 的“谷歌搜索接地”中用于接地 | 不影响谷歌搜索的收录;没有单独的 user-agent 字符串 |
| Applebot-Extended | 退出生成式模型的训练 | Applebot 仍可能为搜索抓取 |
| CCBot(Common Crawl) | 开放的网络存档 | 用 User-agent: CCBot 加 Disallow: / 屏蔽 |
爬虫清单经常变,改文件之前先看各所有者的页面。微软 Bing 博客 2026 年 10 月 30 日新增了一项在 robots.txt 里设置的训练偏好,并说 Allow 设置不会推翻屏蔽 Bingbot 抓取的 robots.txt 规则。
robots.txt 怎么工作
标准 RFC 9309 说,这些规则不是一种访问授权,所以它只是请求,不强制执行。文件必须放在网站顶层的 /robots.txt;最具体的匹配规则优先;如果因为服务器错误无法访问文件,爬虫必须当作完全禁止,如果只是文件不存在,则可以抓取任何内容。爬虫一般不应使用超过 24 小时的缓存副本。爬虫名称的匹配不区分大小写。
示例设置
下面的规则允许搜索爬虫,并对那些所有者另设了独立标识的训练爬虫选择退出。这是 OpenAI 页面描述的组合,由你自己决定,不是哪家厂商的建议。
| User-agent | 规则 | 效果 |
|---|---|---|
| OAI-SearchBot | Allow: / | 可以出现在 ChatGPT 搜索里 |
| GPTBot | Disallow: / | 请求 OpenAI 不要把页面用于训练 |
| Claude-SearchBot | Allow: / | 可以被收入搜索索引 |
| ClaudeBot | Disallow: / | 请求 Anthropic 不要为训练收集 |
| PerplexityBot | Allow: / | 可以出现在 Perplexity 结果里 |
| Google-Extended | Disallow: / | 请求谷歌不要把页面用于 Gemini 的训练和接地 |
| Applebot-Extended | Disallow: / | 退出苹果的训练使用 |
| CCBot | Disallow: / | 不让 Common Crawl 抓取 |
| * | Allow: / | 其他爬虫都可以抓取 |
谷歌 AI 概览和 AI 模式的资格,取决于 Googlebot 的收录和摘要控制,而不取决于 Google-Extended。
llms.txt 呢?
谷歌 2026 年 7 月的指南说,创建 llms.txt 这类不必要的 AI 文本文件,既不会损害也不会帮助你在谷歌搜索里的可见度,因为谷歌搜索会忽略它们。微软、OpenAI、Anthropic、Perplexity 和苹果是否读取它,我们没有找到官方说法。
Vokolla 沃声自己的文件怎么设置
2026 年 11 月 19 日,vokolla.com/robots.txt 允许所有爬虫抓取公开页面,请它们不要进入 /api/ 和 /admin/(公开的 API 路径保持开放),并列出了站点地图。没有点名任何 AI 爬虫,所以没有屏蔽任何一个。我们的网站还提供一个介绍套餐的 /llms.txt。
在 Vokolla 沃声发稿
Vokolla 沃声的价格公开,每篇 US$69(约 ¥460)起,不用询价,不用和销售沟通,也不用订阅。稿件自己写,或者用 Vokolla 新闻稿 AI 助手起草(可以先用中文写要点);套餐自己选,网上付款,发布后拿到列出全部上线链接的报告,发布前每篇都由编辑审核。可以先每 30 天免费发一篇试试,全部套餐见价格页。人民币按欧洲央行 2026-11-03 参考汇率折算,1 美元约 6.67 元。
常见问题
OAI-SearchBot 和 GPTBot 有什么区别?
OAI-SearchBot 用于 ChatGPT 里的搜索;GPTBot 用于训练生成式 AI 模型,各有自己的 robots.txt 设置。
屏蔽 GPTBot 会让我从 ChatGPT 里消失吗?
OpenAI 说每项设置相互独立;选择退出 OAI-SearchBot 的网站不会出现在 ChatGPT 搜索回答里。
Google-Extended 会影响谷歌搜索吗?
谷歌说它不影响谷歌搜索的收录,也不是排名信号。
robots.txt 是安全措施吗?
不是。RFC 9309 说它的规则不是一种访问授权。
需要 llms.txt 文件吗?
谷歌搜索会忽略它;其他厂商没有说明。
这一步可以用到的 Vokolla 页面
- 发稿套餐 →六个套餐,每篇 US$69 至 US$659,均附全部上线链接的报告。
- 价格 →每个套餐的公开价格、覆盖范围和包含内容,放在一起对比。
- 免费发稿 →每 30 天可免费发一篇,编辑审核后发布到新闻网站。
- 新闻稿 AI 助手 →把你的 AI 助手连到 Vokolla,起草、检查并保存稿件。
资料来源
由 Vokolla 沃声编辑团队撰写并核对。文中的套餐由 Vokolla 沃声提供,价格和媒体以上述日期 vokolla.com 公开的信息为准,文中引用的结果来自我们自己发布的稿件。搜索排名受很多因素影响,任何发稿服务都无法保证。
- OpenAI:OpenAI 爬虫概览(OAI-SearchBot、GPTBot、ChatGPT-User) — 核对于 2026-11-05
- Anthropic 帮助中心:Anthropic 会抓取网络数据吗?(ClaudeBot、Claude-User、Claude-SearchBot;遵守 robots.txt) — 核对于 2026-11-05
- Perplexity:Perplexity 爬虫(PerplexityBot、Perplexity-User) — 核对于 2026-11-05
- Google 搜索中心:Google 常用抓取工具(Google-Extended;2026-10-30 更新) — 核对于 2026-11-05
- Apple 支持:关于 Applebot(用 Applebot-Extended 退出训练;nosnippet) — 核对于 2026-11-05
- Common Crawl:CCBot(用 User-agent: CCBot、Disallow: / 屏蔽) — 核对于 2026-11-05
- 微软 Bing 博客:Your content, your choice: clearer preferences for training and grounding(2026-10-30;在 robots.txt 里设置 AI 训练偏好;Allow 设置不会推翻屏蔽 Bingbot 的 robots.txt 规则) — 核对于 2026-11-19
- IETF RFC 9309:机器人排除协议(2022 年 9 月):不是访问授权;最具体的匹配优先 — 核对于 2026-11-05
- Google 搜索中心:为生成式 AI 功能优化你的网站(2026-07-10 更新):不需要新文件;llms.txt 被忽略;不真实的“提及”没有帮助 — 核对于 2026-11-05
- Google 搜索中心:AI 功能与您的网站(2025-12-10 更新) — 核对于 2026-11-04
- Vokolla 沃声发布记录:我们自己在今日美国和合作网络上发布的稿件(2026 年 10 月),2026-11-04 和 11-07 的谷歌、Bing 与 AI 回答检查 (内部记录,方法见正文) — 核对于 2026-11-04
- Vokolla 沃声:新闻稿编辑规范 — 核对于 2026-11-04